Apunte de una clase. Psicometría. Un solo tema: la Teoría de Respuesta al Ítem. Lo de antes (la Teoría Clásica de los Tests) se da por visto.
1. De dónde sale y qué problema resuelve
La Teoría Clásica de los Tests deja una deuda. La dificultad de un ítem depende de quién lo respondió, y la habilidad de una persona depende de qué ítems le tocaron. Si el grupo es muy capaz, el mismo ítem parece fácil. Si el examen es duro, la misma persona parece poco hábil. Las dos cifras están atadas a la muestra.
La Teoría de Respuesta al Ítem, la TRI, intenta separarlas. Describe la probabilidad de acertar un ítem como una función de dos cosas: el nivel de rasgo de la persona y las propiedades del ítem. La idea no nace en los años ochenta. Georg Rasch la formaliza en 1960 con su modelo probabilístico para tests de inteligencia y de logro. Allan Birnbaum, hacia 1968, aporta los modelos de dos y tres parámetros. Frederic Lord publica en 1980 Applications of Item Response Theory to Practical Testing Problems, el libro que la vuelve herramienta de trabajo y no solo modelo matemático.
Lord y Novick habían puesto las bases en 1968, en Statistical Theories of Mental Test Scores. Rasch, Birnbaum y Lord son los tres nombres que caen en el parcial. No se intercambian.
2. El rasgo latente y la curva característica
Theta es el rasgo que el test quiere medir: habilidad, conocimiento, actitud. No se observa directo. Se estima. Por convención se expresa en una escala con media cero y desviación uno, de modo que un theta de 1 está una desviación por encima de la media del grupo de calibración.
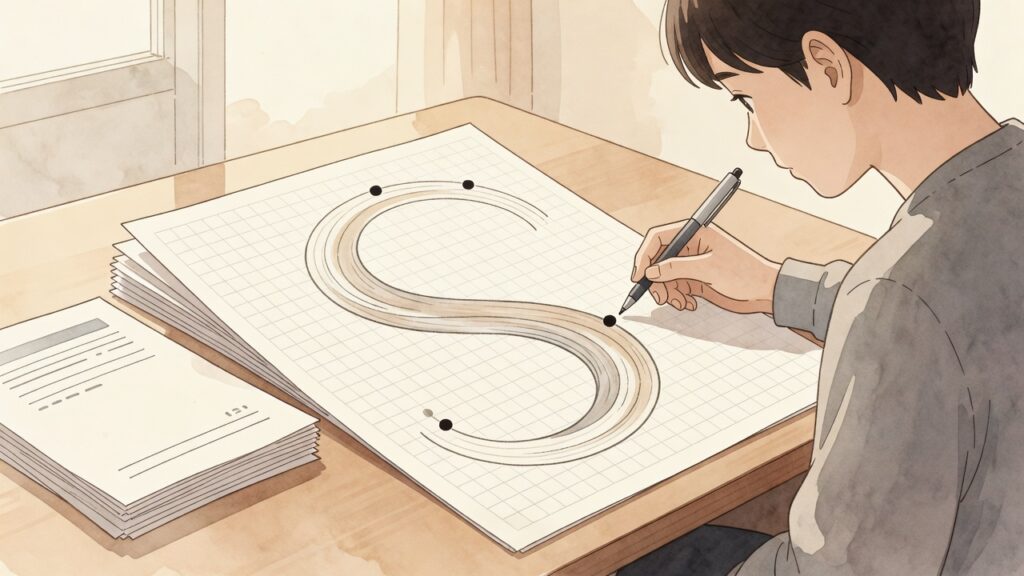
La curva característica del ítem es el corazón del modelo. En el eje horizontal va theta. En el vertical, la probabilidad de acertar, entre cero y uno. La curva sube de izquierda a derecha: a mayor rasgo, mayor probabilidad de respuesta correcta. Esa forma de S es lo que hay que saber dibujar.
Tres cosas se leen en esa curva, y cada una es un parámetro.
- Dificultad (b). Es el punto de theta donde la probabilidad de acertar llega a la mitad del recorrido útil de la curva. Un ítem con b alto lo aciertan solo las personas con rasgo alto. Se mide en la misma escala que theta.
- Discriminación (a). Es la pendiente. Un ítem con pendiente pronunciada separa bien a quien está justo por debajo de su dificultad de quien está justo por encima. Un ítem con pendiente plana acierta casi igual alguien con poco rasgo y alguien con mucho, y aporta poca información.
- Pseudoazar (c). Es la asíntota inferior. En un ítem de opción múltiple, alguien sin ningún conocimiento acierta a veces por casualidad. El parámetro c recoge esa probabilidad de acierto sin rasgo. En un ítem de cuatro opciones, el azar puro daría 0,25, pero c suele estimarse por debajo de eso porque los distractores no son igual de atractivos.
3. Los tres modelos logísticos
El modelo de un parámetro, el de Rasch, solo estima la dificultad. Asume que los ítems discriminan por igual y que no hay acierto por azar. Es el más exigente con los datos y el más parco en supuestos: si un ítem no encaja, se va el ítem, no se complica el modelo. Por eso Rasch se usa mucho en construcción de bancos de ítems, donde se quiere una escala limpia.
El modelo de dos parámetros, asociado a Birnbaum, estima dificultad y discriminación. Admite que unos ítems separan con más fineza que otros. El de tres parámetros suma el pseudoazar, y es el que se usa cuando los ítems son de opción múltiple y el acierto por casualidad es real.
| 1 parámetro (Rasch) | 2 parámetros | 3 parámetros | |
|---|---|---|---|
| Qué estima | Solo dificultad | Dificultad y discriminación | Dificultad, discriminación y pseudoazar |
| Supuesto fuerte | Los ítems discriminan por igual | No hay acierto por azar | El acierto por azar existe y se mide |
| Cuándo conviene | Bancos de ítems, escala única | Ítems abiertos o de crédito parcial | Opción múltiple |
| Costo | Rechaza ítems que no encajan | Pide más datos por ítem | El más inestable con muestras chicas |
Embretson y Reise recogen esta familia en Item Response Theory for Psychologists, el manual de referencia para quien viene de psicología y no de estadística. Sirve para el marco, no para memorizar fórmulas.
4. Los supuestos que el parcial pregunta
La TRI no se aplica porque sí. Descansa en supuestos, y confundirlos es la pregunta típica.
- Unidimensionalidad. El conjunto de ítems mide un solo rasgo dominante. Si un examen de álgebra mezcla cálculo y lectura avanzada, la curva deja de tener una lectura clara, porque dos rasgos empujan la respuesta.
- Independencia local. Dado el nivel de rasgo, las respuestas a dos ítems son independientes entre sí. Si acertar el ítem 4 entrega la respuesta del ítem 5, el supuesto se rompe. La dependencia local infla la precisión aparente del test.
- Monotonicidad. A mayor rasgo, mayor probabilidad de acertar. La curva no baja. Si un ítem lo aciertan más las personas de rasgo bajo que las de rasgo alto, ese ítem está mal construido o mide al revés.
Hay un cuarto que conviene nombrar: la invarianza. Los parámetros del ítem no deberían cambiar según el grupo que responde, y el rasgo estimado no debería cambiar según qué ítems se usaron. Esa es la promesa que la Teoría Clásica no podía cumplir, y es la que justifica todo el aparato.
5. Información, error y para qué sirve
En la Teoría Clásica, el error de medición es uno solo para todo el mundo. En la TRI, el error cambia según el nivel de rasgo. Un ítem fácil no informa nada sobre alguien de rasgo muy alto: esa persona lo acierta de fijo, y su respuesta no dice dónde está. La función de información del ítem dice en qué tramo de theta ese ítem aporta, y cuánto.
La información del test es la suma de la información de sus ítems. Donde la información es alta, el error estándar es bajo, y al revés. Por eso un test bien armado no es el que tiene ítems difíciles, sino el que concentra información donde están las personas que quiere medir.
De ahí salen los usos que sí caen en el parcial.
- Tests adaptativos por computadora. Si la persona acierta, el siguiente ítem es más difícil. Si falla, es más fácil. Se elige en cada paso el ítem que más informa dado el theta estimado hasta ahí. Con menos ítems se llega a la misma precisión.
- Funcionamiento diferencial del ítem. Un ítem funciona distinto si dos personas con el mismo rasgo tienen distinta probabilidad de acertarlo según el grupo al que pertenecen. La TRI permite detectarlo porque compara las curvas, no los puntajes brutos.
- Equiparación. Poner en la misma escala dos formas de un examen. Como los parámetros no dependen del grupo, se puede calibrar un banco y armar formas distintas que midan lo mismo.
- Qué es theta y en qué escala se expresa.
- Los tres parámetros: b dificultad, a discriminación, c pseudoazar, y qué hace cada uno en la curva.
- Diferencia entre el modelo de uno, dos y tres parámetros, y quién está detrás del de uno (Rasch) y del de dos (Birnbaum).
- Los tres supuestos: unidimensionalidad, independencia local, monotonicidad. Saber decir que los dos primeros no son lo mismo.
- Por qué el error en la TRI depende del nivel de rasgo y en la Teoría Clásica no.
- Un uso concreto: el test adaptativo elige el ítem que más informa, no el más difícil.
7. Cómo se calibra, en concreto
Calibrar es estimar los parámetros de cada ítem a partir de las respuestas de un grupo. No se hace a ojo. Se parte de una respuesta tentativa y se ajusta hasta que el modelo reproduce con la mayor fidelidad el patrón de aciertos y fallos observado. Con el modelo de un parámetro alcanza una muestra de unos pocos cientos. Con el de tres parámetros, donde hay que estimar también el pseudoazar, se piden grupos bastante más grandes, del orden del millar, porque ese parámetro es el más inestable.
Una vez calibrado el banco, estimar el theta de una persona nueva es otro paso. Se usa su patrón de respuestas, no su número de aciertos. Dos personas con el mismo puntaje bruto pueden tener distinto theta si acertaron ítems de distinta dificultad. Esa es la diferencia operativa con la Teoría Clásica, y es la que justifica el cálculo.
Un caso para aterrizarlo
Piensa en un banco de 40 ítems de razonamiento, calibrado. Llega alguien y acierta 20. En la clásica, eso es un puntaje y se acabó. En la TRI se mira cuáles 20. Si acertó los 20 más difíciles y falló los fáciles, el patrón es raro: o respondió al azar, o el test no le mide lo que creemos. Si acertó los 20 más fáciles y falló el resto, el theta cae cerca de la dificultad del ítem frontera, y el error es chico porque hay información justo ahí.
El test adaptativo usa eso en vivo. Arranca con un ítem de dificultad media. Si lo acierta, sube. Si lo falla, baja. Se detiene cuando el error estándar del theta baja de un umbral, no cuando se acaban los ítems. Por eso una persona puede terminar en 12 ítems y otra en 25, y las dos tener una medida igual de precisa.
Qué mirar en la salida de un programa
Cuando un programa entrega la calibración, tres cifras importan por ítem y conviene saber leerlas sin tratarlas como nota.
- El parámetro b, la dificultad, en la misma escala que theta. Un b de 1,5 es un ítem que solo separa en la zona alta.
- El parámetro a, la discriminación. Por debajo de 0,8 el ítem aporta poco. Entre 0,8 y 2,5 trabaja bien. Por encima, separa mucho pero en un rango muy estrecho.
- El ajuste. Un ítem puede tener parámetros estimados y aun así no encajar en el modelo. El estadístico de ajuste dice si las respuestas observadas se parecen a las que el modelo predice. Si no se parecen, el ítem se revisa o se saca del banco, no se fuerza.
Esos rangos son guías de trabajo, no cortes sagrados. Cambian con el modelo y con el programa. Lo que no cambia es la lógica: un parámetro estimado no es un parámetro aceptable. Hay que mirar el ajuste antes de dejar el ítem en el banco.
De la curva al número
Conviene poder pasar de la curva a una cifra sin calculadora, porque el parcial pide lectura y no cuentas. Toma un ítem de tres parámetros con dificultad 0, discriminación alta y pseudoazar de 0,20. Para una persona con theta 0, justo en la dificultad, la probabilidad de acertar no es 0,50. El pseudoazar levanta el piso, así que la probabilidad queda a medio camino entre 0,20 y 1, cerca de 0,60. Para alguien con theta muy bajo, la probabilidad no cae a cero: se acerca a 0,20, que es el acierto por azar. Para alguien con theta alto, se acerca a 1 sin llegar del todo.
Esa lectura alcanza para responder la mayoría de las preguntas de gráfico. Localiza la dificultad en el punto medio del recorrido, la discriminación en qué tan parada está la curva, y el pseudoazar en desde dónde arranca. Si una curva arranca en cero, no hay pseudoazar y el modelo es de uno o de dos parámetros. Si arranca por encima de cero, es de tres.
Errores que se repiten al aplicar la TRI
- Calibrar con un grupo que no representa a quien va a responder después. Los parámetros salen limpios y no sirven para el uso real, porque la escala quedó anclada a otro grupo.
- Meter en el mismo banco ítems que comparten un texto largo. Rompen la independencia local y la precisión del test queda inflada.
- Confiar en el theta estimado con muy pocos ítems respondidos. El número existe, pero su error es tan grande que no distingue a una persona de otra.
- Usar el modelo de tres parámetros con una muestra chica. El pseudoazar se estima mal y arrastra a los otros dos parámetros.
- Declarar un ítem válido porque ajusta al modelo. El ajuste dice que el modelo lo describe. No dice que mida lo que se quería medir.
Vale la pena fijar los nombres con su obra, porque el parcial los cruza. Rasch, en 1960, propone un modelo donde la respuesta depende solo de la diferencia entre la habilidad de la persona y la dificultad del ítem. Es una idea deliberadamente simple, y su fuerza está en lo que exige: si el ítem no se comporta así, no entra. Birnbaum relaja eso y deja que cada ítem discrimine a su modo. Lord, en 1980, baja todo esto a los problemas concretos de armar un examen: cómo elegir ítems, cómo armar formas equivalentes, cómo leer el error. Embretson y Reise lo traducen después al lenguaje de quien investiga en psicología. Cuatro nombres, cuatro aportes distintos. Cruzarlos es la pregunta fácil de armar y la fácil de fallar.
6. Lo que no hay que afirmar
La TRI no hace que un test sea válido. Estima parámetros con precisión. La validez sigue siendo una pregunta sobre qué mide el test, y se responde con evidencia, no con un modelo. Tampoco exige muestras enormes por decreto: el modelo de un parámetro se calibra con muestras más chicas que el de tres, que con pocos datos estima mal el pseudoazar. Y no reemplaza a la Teoría Clásica en todo. Para un examen de aula, con un grupo y una sola forma, la clásica sigue siendo suficiente y más transparente.
La TRI vale cuando hay un banco de ítems, varias formas, o la necesidad de comparar personas que respondieron ítems distintos. Ahí la invarianza paga el costo de cálculo.